简单介绍一下您的团队,即可获得:
 G2 评分 4.7 / 5
Web Unlocker 把一个 YouTube 搜索结果页连同其中最多 20 个视频按 1 页计费。Apify 和 Bright Data 上的 YouTube 采集工具则把每个视频各算作一行来计费。
API 每天最多 100 次搜索。
这里 1,000 次搜索只需 $0.98。
像 YouTube 一样筛选搜索,按上传日期或按观看次数:每个筛选多一页,价格相同。
1,000 次搜索、每次 20 个视频的费用
1,000 个搜索页面和 20,000 个视频,按公布价格计算
SerpApi 按每次搜索计费。Bright Data 把每个视频按一条记录计费,每 1,000 条 $1.50。Apify 上最常用的 YouTube 采集工具按每个视频计费,每 1,000 个 $2.40 至 $4.00。
YouTube Data API 在每天 100 次搜索用完之前免费,而 YouTube 采集工具按每个视频计费。下面是各条路线完成同样 1,000 次搜索所需的条件。
| 需要什么 |  Web Unlocker | YouTube Data API | Apify | SerpApi |
|---|---|---|---|---|
| 每天搜索次数 | 不设上限 | 100 | 不设上限 | 按套餐 |
| 您按什么付费 | 一页 | 配额内免费 | 每个视频 | 每次搜索 |
| 1,000 次搜索,每次 20 个视频 | $0.98 | 10 天的配额 | $48 至 $80 | $25 |
| 任意视频的转写文稿 | 借助 Cloud Browser | 仅限自己的视频 | 是 | 否 |
| 无需 Google 项目即可开始 | 是 | 否 | 是 | 是 |
| 整个页面的 HTML | 是 | 否 | 否 | 否 |
要采集的不只是 YouTube?Web Unlocker 以同样的方式、同样的价格返回任何页面。
频道的上传播放列表第一页列出 100 个视频,之后每翻一页多出 78 个。Web Unlocker 每页只计费一次:10 页,802 个视频,$0.0098。
Apify 每 1,000 个视频收费 $2.40 至 $4.00。
这里 800 个只需 1 美分。
YouTube 把页面上的每个视频以 JSON 的形式放在 HTML 里。Web Unlocker 返回这份 HTML,几行代码就能从中读出视频。
填写上面的表单。密钥会在一个工作日内通过邮件送达。
按关键词搜索,选一个视频看它的数据,或选一个频道的上传列表获取它的全部视频。
页面上的每个视频都带有标题、观看次数、频道、日期和时长。
pip install requestsGOLOGIN_SCRAPING_API_KEY=your_key python youtube_search.pyhttps://parsing.webunlocker.gologin.com/v1/scrapeimport json
import os
import time
from urllib.parse import quote_plus
import requests
search = "home espresso"
def scrape(url):
for attempt in range(3):
response = requests.get(
"https://parsing.webunlocker.gologin.com/v1/scrape",
params={"url": url, "geo": "us", "format": "json"},
headers={"apikey": os.environ["GOLOGIN_SCRAPING_API_KEY"]},
timeout=90,
)
page = response.json().get("data", {}).get("html", "") if response.ok else ""
if '"videoRenderer"' in page:
return page
time.sleep(5)
raise RuntimeError("No videos came back, try again later")
def find(node, key):
if isinstance(node, dict):
for name, value in node.items():
if name == key:
yield value
yield from find(value, key)
elif isinstance(node, list):
for item in node:
yield from find(item, key)
def text(field):
if not field:
return None
return field.get("simpleText") or "".join(run["text"] for run in field.get("runs", []))
page = scrape(f"https://www.youtube.com/results?search_query={quote_plus(search)}")
data = json.loads(page.split("var ytInitialData = ")[1].split(";</script>")[0])
videos = {}
for video in find(data, "videoRenderer"):
videos[video["videoId"]] = {
"title": text(video.get("title")),
"url": f"https://www.youtube.com/watch?v={video['videoId']}",
"channel": text(video.get("ownerText")),
"views": text(video.get("viewCountText")),
"published": text(video.get("publishedTimeText")),
"length": text(video.get("lengthText")),
}
print(json.dumps(list(videos.values()), indent=2, ensure_ascii=False))
print(f"{len(videos)} videos from one search page")GOLOGIN_SCRAPING_API_KEY=your_key node youtube-channel.mjshttps://parsing.webunlocker.gologin.com/v1/scrapeconst channelId = 'UCBJycsmduvYEL83R_U4JriQ';
const wanted = 800;
const uploads = `UU${channelId.slice(2)}`;
async function scrape(url) {
for (let attempt = 1; attempt <= 3; attempt++) {
const params = new URLSearchParams({ url, geo: 'us', format: 'json' });
const response = await fetch(`https://parsing.webunlocker.gologin.com/v1/scrape?${params}`, {
headers: { apikey: process.env.GOLOGIN_SCRAPING_API_KEY },
});
const page = response.ok ? (await response.json()).data?.html : '';
if (page?.includes('var ytInitialData = ')) return JSON.parse(page.split('var ytInitialData = ')[1].split(';</script>')[0]);
await new Promise((resolve) => setTimeout(resolve, 5000));
}
throw new Error('The page came back without videos, try again later');
}
function* find(node, key) {
if (Array.isArray(node)) for (const item of node) yield* find(item, key);
else if (node && typeof node === 'object') {
for (const [name, value] of Object.entries(node)) {
if (name === key) yield value;
yield* find(value, key);
}
}
}
const videos = new Map();
for (const item of find(await scrape(`https://www.youtube.com/playlist?list=${uploads}`), 'lockupViewModel')) {
if (item.contentType === 'LOCKUP_CONTENT_TYPE_VIDEO') videos.set(item.contentId, item.metadata.lockupMetadataViewModel.title.content);
}
let pages = 1;
while (videos.size < wanted) {
const last = [...videos.keys()].at(-1);
const before = videos.size;
for (const item of find(await scrape(`https://www.youtube.com/watch?v=${last}&list=${uploads}`), 'playlistPanelVideoRenderer')) {
videos.set(item.videoId, item.title.simpleText);
}
pages++;
if (videos.size === before) break;
}
console.table([...videos].slice(0, 5).map(([id, title]) => ({ title, url: `https://www.youtube.com/watch?v=${id}` })));
console.log(`${videos.size} videos in ${pages} pages: $${(pages * 0.00098).toFixed(4)} on the Growth plan`);GOLOGIN_SCRAPING_API_KEY=your_key node youtube-video.mjshttps://parsing.webunlocker.gologin.com/v1/scrapeconst video = 'https://www.youtube.com/watch?v=jNQXAC9IVRw';
async function scrape(url) {
for (let attempt = 1; attempt <= 3; attempt++) {
const params = new URLSearchParams({ url, geo: 'us', format: 'json' });
const response = await fetch(`https://parsing.webunlocker.gologin.com/v1/scrape?${params}`, {
headers: { apikey: process.env.GOLOGIN_SCRAPING_API_KEY },
});
const page = response.ok ? (await response.json()).data?.html : '';
if (page?.includes('var ytInitialPlayerResponse = ')) return page;
await new Promise((resolve) => setTimeout(resolve, 5000));
}
throw new Error('The video page came back empty, try again later');
}
const page = await scrape(video);
const player = JSON.parse(page.split('var ytInitialPlayerResponse = ')[1].split(';var meta')[0]);
const { videoDetails: details, microformat, captions } = player;
console.log({
title: details.title,
channel: details.author,
views: Number(details.viewCount),
likes: Number(page.match(/along with ([\d,]+) other/)?.[1].replaceAll(',', '')),
comments: page.match(/"contextualInfo":\{"runs":\[\{"text":"([^"]+)"/)?.[1],
published: microformat.playerMicroformatRenderer.publishDate,
seconds: Number(details.lengthSeconds),
tags: details.keywords ?? [],
captions: captions?.playerCaptionsTracklistRenderer.captionTracks.map((track) => track.languageCode) ?? [],
});准备好用在自己的搜索上了吗?获取 API 密钥和免费请求额度。
Web Unlocker 返回 YouTube 最初发送的页面。评论只有滚动时才会加载,转写文稿只有点击后才会出现。Cloud Browser 是替您滚动和点击的附加产品,每月 $4.50 起,含 50 个浏览器小时。
1,000 个视频、每个 100 条评论,合计 $6.95:8.3 个浏览器小时和 6.2 GB 流量。同样的量,Apify 收费 $30 至 $200。
YouTube API 只提供您自己视频的转写文稿,来自服务器的请求只会得到空文件。Cloud Browser 像观众一样打开转写文稿,只需 25 秒。
每个会话都使用您所选国家或地区的住宅 IP。超出套餐的流量为 $1/GB。
通过 Playwright、Puppeteer 或 Claude 运行。了解 Cloud Browser。
一个账户,一个代理网络,一套生态。按任务需要选择产品。
还要采集其他站点?请查看 Reddit、Google Maps 和 Amazon 采集工具,或全部网页采集工具。
有。Web Unlocker 就是一个 YouTube 爬虫 API:向它发送搜索、视频或频道的上传列表,它会用真实浏览器加载页面,并连同 YouTube 藏在页面里的数据一起返回:标题、观看次数、频道、日期和时长。每 1,000 页 $0.98,上面的代码就能读取这些数据。
能。YouTube 视频页包含精确的观看次数、点赞数、评论数、简介、标签、发布日期和字幕语言,另外还有 20 个相关视频,按 1 页计费。上面的“视频数据”标签页就是读取这些内容的。
发送带有您关键词的 youtube.com/results。一页最多返回 20 个视频和最多 25 个 Shorts,每个都带有观看次数、频道、发布时间和时长,按 1 页计费。加上 YouTube 自己的筛选,按上传日期或按观看次数,就能得到其他结果。
默认每个项目每天 100 次搜索调用,每次最多 50 条结果。想要更多,需要提交配额申请并通过 Google 的审核。Web Unlocker 没有每日上限:按页付费,每 1,000 页 $0.98。
免费,但限于配额内:大多数调用每天 10,000 个单位,另加 100 次搜索。超出之后,Google 只有在审核您的项目后才会提高配额。
能。搜索、视频和频道页面都是公开页面,无需登录即可加载。Web Unlocker 像访客的浏览器一样看到它们并返回,不需要 Google 项目,也不需要 API 密钥。
打开频道的上传播放列表:第一页列出 100 个视频及其观看次数和发布时间。然后带着这个播放列表打开其中最后一个视频:每个这样的页面再列出 78 个。10 页就能得到 802 个视频,只需 1 美分。
YouTube 在您滚动时才加载评论,所以 Web Unlocker 不会返回评论。Cloud Browser 替您滚动视频:26 秒 100 条评论,1,000 个视频、每个 100 条评论只需 $6.95。
能,借助 Cloud Browser。YouTube API 只提供您自己视频的转写文稿,来自服务器的请求只会得到空文件。Cloud Browser 像观众一样打开转写文稿,每个视频只需 25 秒。
用 requests 库把搜索地址发送给 Web Unlocker,再从页面中读取视频。上面的 Python 标签页是一份完整的脚本,已在真实 API 上测试过。
能。一个搜索页面最多返回 25 个 Shorts 及其标题和观看次数,频道的 Shorts 标签页列出 48 个,单个 Short 自己的页面则有它的点赞数、评论数和日期。
Web Unlocker 返回的是页面,而不是表格,所以在您看到之前不会丢失任何内容。把它转成 CSV 只需几行代码,或者一句提示词:用 Gologin scraping skill 把页面交给 Claude,让它输出 CSV。
每 1,000 页 $0.98,每个页面价格相同。一次最多含 20 个视频的搜索算 1 页,一个带数据的视频也算 1 页。页面加载失败不收费。套餐每月 $49 起,含 50,000 次请求。
有,可以免费开始:Web Unlocker 附带 1,000 次免费请求,足够完成 1,000 次搜索或采集 1,000 个视频。
这取决于您的需求。YouTube API 每天 100 次搜索免费。Apify 和 Bright Data 出售整理好的现成数据行,并按每个视频计费。Web Unlocker 以一个价格返回整个页面,所以 20 个视频和 1 个视频价格相同。
搜索、视频和频道都是公开页面,无需登录即可加载。Web Unlocker 像访客的浏览器一样加载它们并返回页面。您采集什么、如何使用,由您自己决定,请对照适用于您项目的规则自行核对。
简单介绍一下您的团队,即可获得:
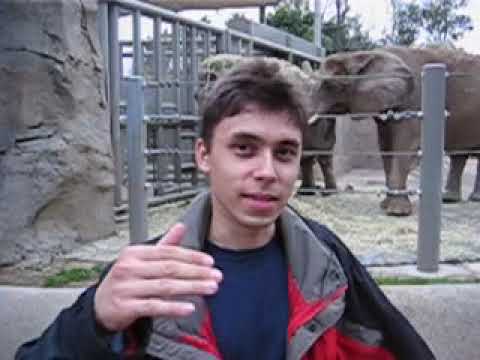
G2 评分 4.7 / 5 0:47
 29:05
 11:47
 10:47
 12:23
 14:20
 11:56
 15:06
 16:36
 10:37
 1:10
 12:28